크레 행동을 AI로 예측해봤더니: 폴란드 연구팀의 머신러닝 실험
결론부터 말할게요. 폴란드 브로츠와프 환경생명과학대학교 연구팀이 크레(크레스티드 게코, 학명 Correlophus ciliatus) 20마리를 1년 넘게 관찰한 기록으로 머신러닝 분류 모델을 만들어봤는데, 실제 활용을 뒷받침할 만한 성능은 나오지 않았어요. 일곱 개 행동 항목별로 F1-score가 가장 높았던 모델들의 정확도가 0.47-0.63이었고, 논문 전체를 통틀어 가장 높았던 정확도도 0.64에 그쳤거든요. 논문도 전반적인 정확도가 기대했던 수준(약 80% 이상)에 못 미쳤다고 스스로 인정했고요. 그리고 하나 더 짚고 갈 게 있어요. 논문도 이 글도 “예측”이라는 말을 쓰지만, 시간적으로 다음에 일어날 행동을 미리 맞히는 실험은 아니에요.
무엇을 맞힌 건지 풀어서 설명하면 이래요. 한 건의 관찰 기록(표의 한 행)에 함께 적힌 다른 행동 항목들을 입력으로 넣어서, 그중 한 항목이 어떤 값이었는지를 알아맞히는 분류 문제예요. 예를 들어 “물을 뿌렸을 때 이 개체가 어떻게 반응했는지”와 “잘 때 어떤 자세였는지”를 가지고 “물을 뿌린 뒤 몸을 핥았는지”를 맞히는 식이죠. 이 구분을 해 두지 않으면 결과를 실제보다 훨씬 대단한 것으로 읽게 돼요.
지금까지 다룬 크레 논문 두 편은 꼬리가 다시 안 자라는 이유를 찾은 유전체 논문과 두 번째 팀이 완성한 유전체 지도였는데, 이번엔 결이 다른 논문이에요. 연구팀은 Pacoń, Kosińska-Selbi, Wełeszczuk, Kochan, Kruszyński 다섯 명이고, 논문은 학술지 Applied Animal Behaviour Science에 2024년 실렸어요. 그럼 이 연구가 무엇을 어떻게 봤는지부터 차례로 볼게요.
어떻게 관찰했을까
연구에 쓰인 개체는 2019년 1월 8일부터 3월 12일 사이에 부화한 크레 20마리예요. 2019년 3월 29일부터 2020년 5월 19일까지, 그러니까 1년하고도 두 달 가까이 관찰했어요. 총 관찰 시간은 1,466시간인데, 오전 8시부터 자정까지는 관찰자가 직접 눈으로 봤고, 야간을 포함한 24시간 관찰은 적외선 카메라(Foscam IP C2M)로 녹화했어요. 사람이 지켜보고 있으면 동물이 평소와 다르게 행동할 수 있어서, 최대한 관찰자가 개입하지 않는 방식으로 계획했대요. 관찰 시간대는 아무렇게나 정한 게 아니라, 사육장 청소 작업이 실제로 이뤄지는 시간대를 반영해서 골랐어요(브리더 인터뷰와 브로츠와프 동물원의 청소 일정을 참고했다고 해요).
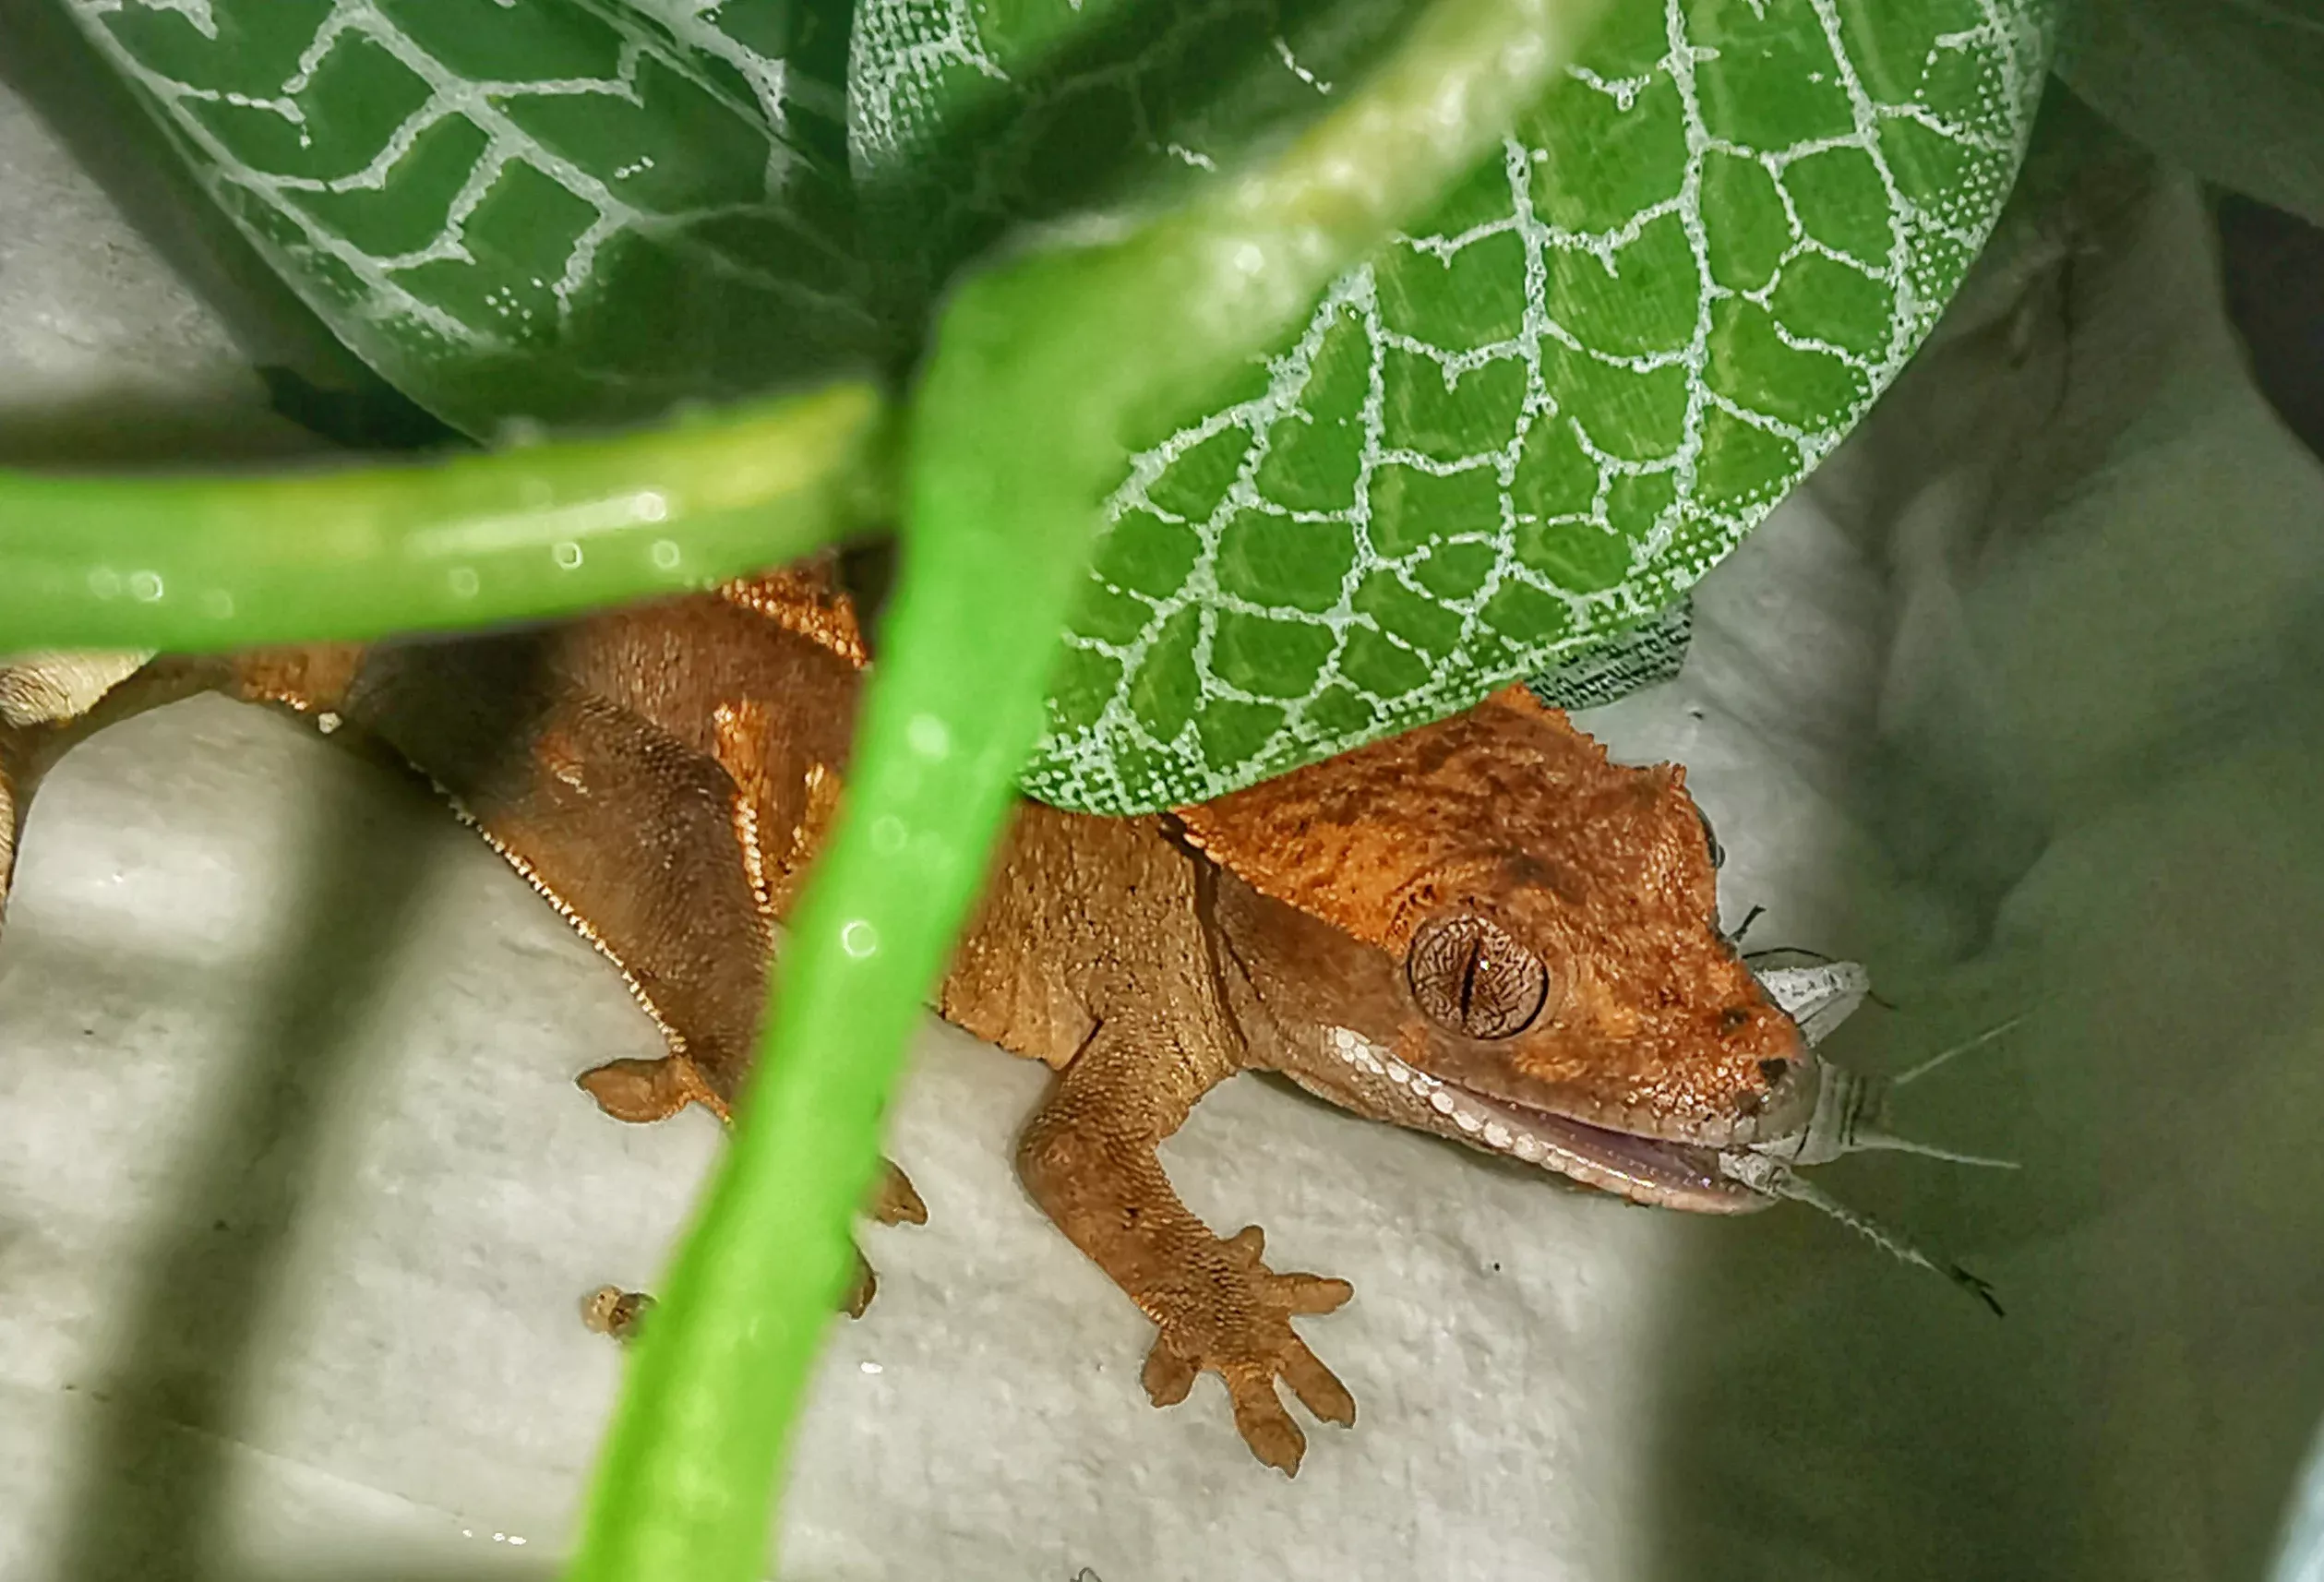
사육장은 33×24×20cm 크기로 전부 똑같이 맞췄고, 코코넛 은신처와 스킨답서스(Scindapsus pictus, 저희 사육장에서도 흔히 쓰는 그 덩굴 식물이에요) 화분, 먹이 그릇을 넣어뒀어요. 은신처는 모든 사육장에서 같은 위치에 뒀고, 사육장마다 같은 벽면에 번호를 붙여 그 면을 “앞면”으로 정했어요. 온도는 22°C에 계절에 따라 ±2°C 정도 변동을 줬고요. 이 실험은 브로츠와프 동물실험윤리위원회의 승인(No. 008/2019)을 받아 진행됐어요.
무엇을 기록했을까
연구팀은 아래 일곱 가지 행동 항목을 관찰해서 데이터로 남겼어요.
| 행동 항목 | 무엇을 기록했나 |
|---|---|
| 수면 자세 | 몸을 쭉 편 자세, 활동적인 자세, S자·U자로 꼬리를 만 자세, 꼬리를 배 밑이나 머리 아래에 넣은 자세 등 |
| 수면 위치 | 은신처 안, 바닥, 사육장 벽면(앞·뒤·좌·우), 코코넛 위 등 |
| 스프레이 반응 | 물을 뿌렸을 때 움직이는지, 머리만 움직이는지, 가만히 있는지, 달아나는지 |
| 스프레이 후 핥기 여부 | 물을 뿌린 뒤 스스로 몸을 핥아 물을 먹는지 안 먹는지 |
| 터치 반응 | 손으로 만졌을 때 짖는지, 숨는지, 은신처로 들어가는지, 뛰어오르는지, 움직이는지, 달아나는지, 가만히 있는지 |
| 손 위에서의 행동 | 손에 올렸을 때 뛰어내리는지, 달리는지, 움직이는지, 가만히 있는지 |
| 사육장에 다시 넣은 후 행동 | 숨는지, 움직이는지, 바닥으로 내려가는지, 달아나는지, 그 자리에 있는지 |
이렇게 모은 관찰 기록은 총 2,200건에 항목(변수)은 12개였어요. 여기서 결측치가 있는 21행을 지우고, 사례가 너무 적은(50건 미만) 범주를 정리하고 나니 최종 2,067행이 남았어요. 범주형 항목을 모두 0/1 지시변수로 펼쳤기 때문에 열은 36개가 됐고요.
재미있게도 연구팀은 “날짜”·”개체 번호”·”계절”은 다른 항목들과의 상관관계가 낮아서 예측에 쓰지 않기로 했어요. 즉 “몇 번 개체인지, 언제 관찰했는지”보다 “그 순간 다른 행동들이 어땠는지”를 가지고 서로를 맞혀보는 방식이에요.
다만 여기에는 짚어둘 점이 있어요. 개체 번호를 입력에서 뺐다고 해서 개체 차이 자체가 사라지는 건 아니에요. 2,067건은 서로 다른 2,067마리가 아니라 같은 20마리를 1년 넘게 반복 관찰한 기록이고, 아래에서 설명할 평가 방식도 개체 단위가 아니라 관찰 건 단위로 데이터를 나눴어요. 그러니까 이 모델의 성적은 “처음 보는 새로운 크레에게도 통하는가”를 잰 값이 아니라, “이 20마리의 관찰 기록 안에서 항목들 사이의 규칙성을 얼마나 잡아내는가”에 가까워요.
어떤 AI를 썼을까
전문적으로 설명하면 연구팀은 의사결정나무(Decision Tree, DT), 그레이디언트 부스팅(Gradient Boosting, GB), 익스트림 그레이디언트 부스팅(XGBoost) 세 가지 분류 알고리즘을 썼어요. 쉽게 말하면 셋 다 “스무고개” 같은 방식으로 데이터를 나눠가는 AI예요. 의사결정나무는 “이 조건이면 예, 아니면 아니오” 하는 질문을 반복해서 답을 좁혀가는 가장 단순한 형태고, 그레이디언트 부스팅과 XGBoost는 이런 단순한 나무를 여러 개(이 연구에서는 100개) 만들어서, 앞 나무가 틀린 부분을 다음 나무가 보완하는 식으로 팀을 이뤄 정답률을 끌어올리는 방식이에요.
성능은 5겹 교차검증(5-fold cross-validation)으로 쟀어요. 전문적으로 설명하면 전체 데이터를 다섯 덩어리로 나눈 뒤, 네 덩어리로 모델을 학습시키고 남은 한 덩어리로 채점하는 과정을 다섯 번 반복해서 평균을 내는 방법이에요. 쉽게 말하면 문제집을 다섯 등분해서 네 부분으로 공부하고 나머지 한 부분으로 시험을 보되, 시험 범위를 다섯 번 돌려가며 바꿔 평균 점수를 내는 셈이죠. 2,067건은 5로 나누어떨어지지 않아서 회차마다 시험 범위가 413건이나 414건으로 조금씩 달라지는데, 뒤에 나올 그림들은 시험 413건, 공부 1,654건인 회차의 것이에요. 이 숫자는 그림을 읽을 때 필요하니 기억해 두면 좋아요.
결과는 어땠을까
모델 성능은 정확도(accuracy)뿐 아니라 정밀도·재현율·F1-score까지 같이 봤어요. 전문적으로 설명하면 이 데이터는 항목별로 특정 반응이 다른 반응보다 훨씬 자주 나오는, 이른바 클래스 불균형이 심해서 정확도 하나만 보면 오해하기 쉬워요(예를 들어 “거의 항상 A로 반응한다”는 걸 모델이 몰라도 그냥 매번 A라고 찍으면 정확도가 높게 나올 수 있거든요). 그래서 연구팀은 정밀도와 재현율의 조화평균인 F1-score를 더 중요한 지표로 삼았고, 클래스별 점수를 단순 평균하는 매크로 방식으로 계산했어요. 쉽게 말하면 드물게 나오는 반응도 흔한 반응과 같은 비중으로 채점하는 방식이라, 다수 쪽만 찍는 모델은 점수가 깎여요.
다만 F1-score가 만능은 아니에요. 클래스가 몇 개인지, 각 클래스가 얼마나 치우쳐 있는지에 따라 값의 의미가 달라지기 때문에, 항목이 다르면 F1-score끼리도 곧바로 비교하기 어렵다는 점은 염두에 둬야 해요.
항목별로 F1-score가 가장 높았던 모델을 정리하면 아래와 같아요.
| 행동 항목 | F1-score가 가장 높았던 모델 | F1-score | 정확도 |
|---|---|---|---|
| 스프레이 후 핥기 여부 | Decision Tree | 0.59 | 0.63 |
| 스프레이 반응 | Decision Tree | 0.44 | 0.57 |
| 수면 자세 | Gradient Boosting | 0.56 | 0.58 |
| 수면 위치 | Gradient Boosting | 0.29 | 0.52 |
| 터치 반응 | XGBoost | 0.42 | 0.52 |
| 손 위에서의 행동 | XGBoost | 0.32 | 0.51 |
| 사육장에 다시 넣은 후 행동 | XGBoost | 0.26 | 0.47 |
표를 볼 때 주의할 게 하나 있어요. 여기서 “가장 우수한 모델”은 F1-score 기준이라, 같은 항목에서 정확도만 놓고 보면 다른 모델이 더 높은 경우가 있어요. “사육장에 다시 넣은 후 행동”이 그런 경우로, F1-score는 XGBoost가 0.26으로 가장 높지만 정확도는 의사결정나무가 0.56으로 XGBoost의 0.47보다 훨씬 높아요. 그런데도 F1-score를 기준으로 삼은 이유가 바로 위에서 말한 클래스 불균형이에요. 이 항목은 앞의 관찰 표에 적은 다섯 가지 반응 중 사례가 적은 범주를 정리하고 남은 네 가지로 모델링됐는데, 그중 하나가 전체의 57%를 차지하거든요(논문 표 3). 논문 전체에서 정확도가 가장 높았던 값도 표에 없는데, 핥기 여부를 그레이디언트 부스팅으로 맞혔을 때의 0.64예요(F1-score는 0.56으로 의사결정나무보다 낮아요).
가장 눈에 띄는 건 “물을 뿌린 뒤 핥는지 안 핥는지”가 일곱 항목 중 가장 잘 맞혀졌다는 점이에요(정확도 0.63, F1-score 0.59). 이 항목은 답이 “핥는다”·”핥지 않는다” 둘뿐인 유일한 이분 항목이라, 답의 가짓수가 3-7개인 다른 항목보다 구조적으로 단순했다는 점이 유리하게 작용했을 수 있어요(다만 클래스가 둘이라고 항상 맞히기 쉬운 건 아니라서, 이것만으로 설명이 끝나지는 않아요).
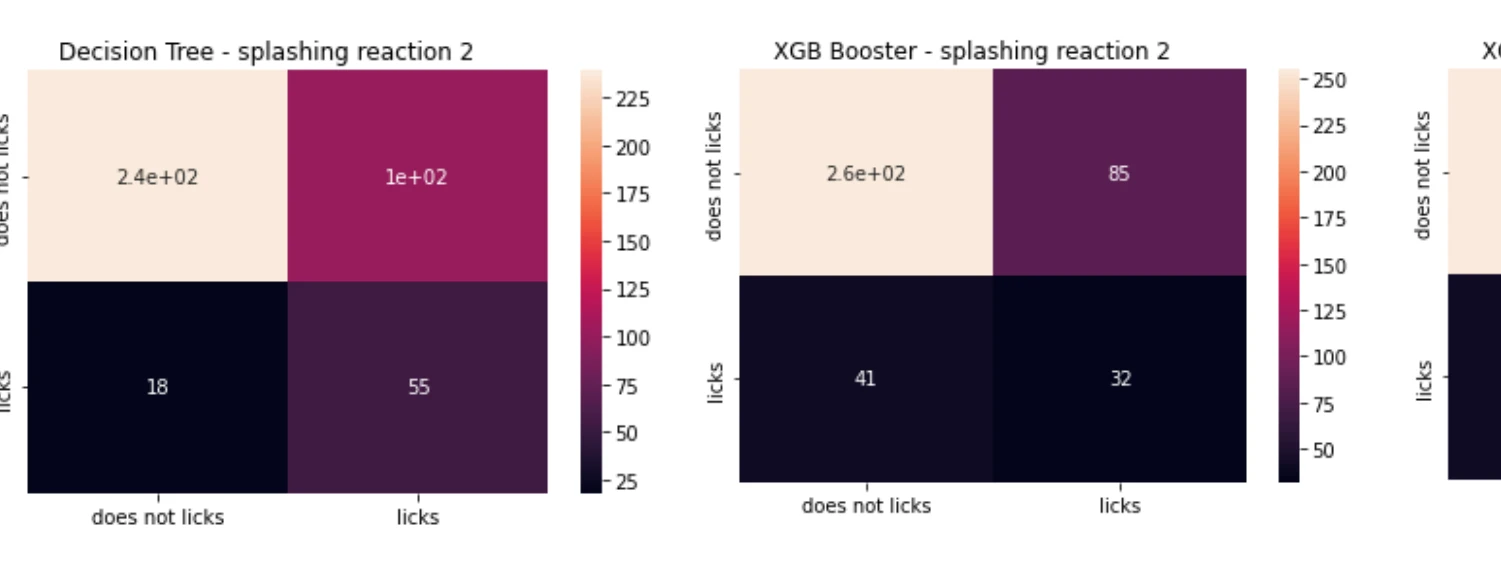
이 그림(혼동 행렬)은 실제로 관찰된 반응과 AI가 예측한 반응을 맞대어 놓은 표예요. 의사결정나무 쪽을 보면 “핥지 않는다”를 “핥지 않는다”로 맞힌 경우가 240여 건으로 가장 많고, “핥는다”를 맞힌 경우도 55건이나 돼요. 반대로 “핥는다”인데 “핥지 않는다”로 틀린 경우가 18건, “핥지 않는다”인데 “핥는다”로 틀린 경우가 100여 건으로, 특히 실제로는 안 핥았는데 핥을 거라고 잘못 예측하는 쪽의 오차가 좀 더 컸어요.
네 칸을 더하면 413건 정도가 되는데, 앞에서 말한 교차검증 한 번의 시험 범위와 같은 규모예요(바로 아래 나무 그림에 적힌 학습 데이터 1,654건도 마찬가지로 맞아떨어져요). 그러니까 이 그림은 다섯 번의 시험 중 한 번의 결과예요. 이 한 장만 놓고 정확도를 계산하면 (240+55)/413으로 약 0.71이 나와서 표의 0.63보다 높은데, 표의 값은 다섯 번을 평균한 것이라 그림 한 장과 일치하지 않는 게 정상이에요. 논문 본문도 이 그림의 수치를 “240 이상”·”100 이상”처럼 어림값으로 적고 있고요.
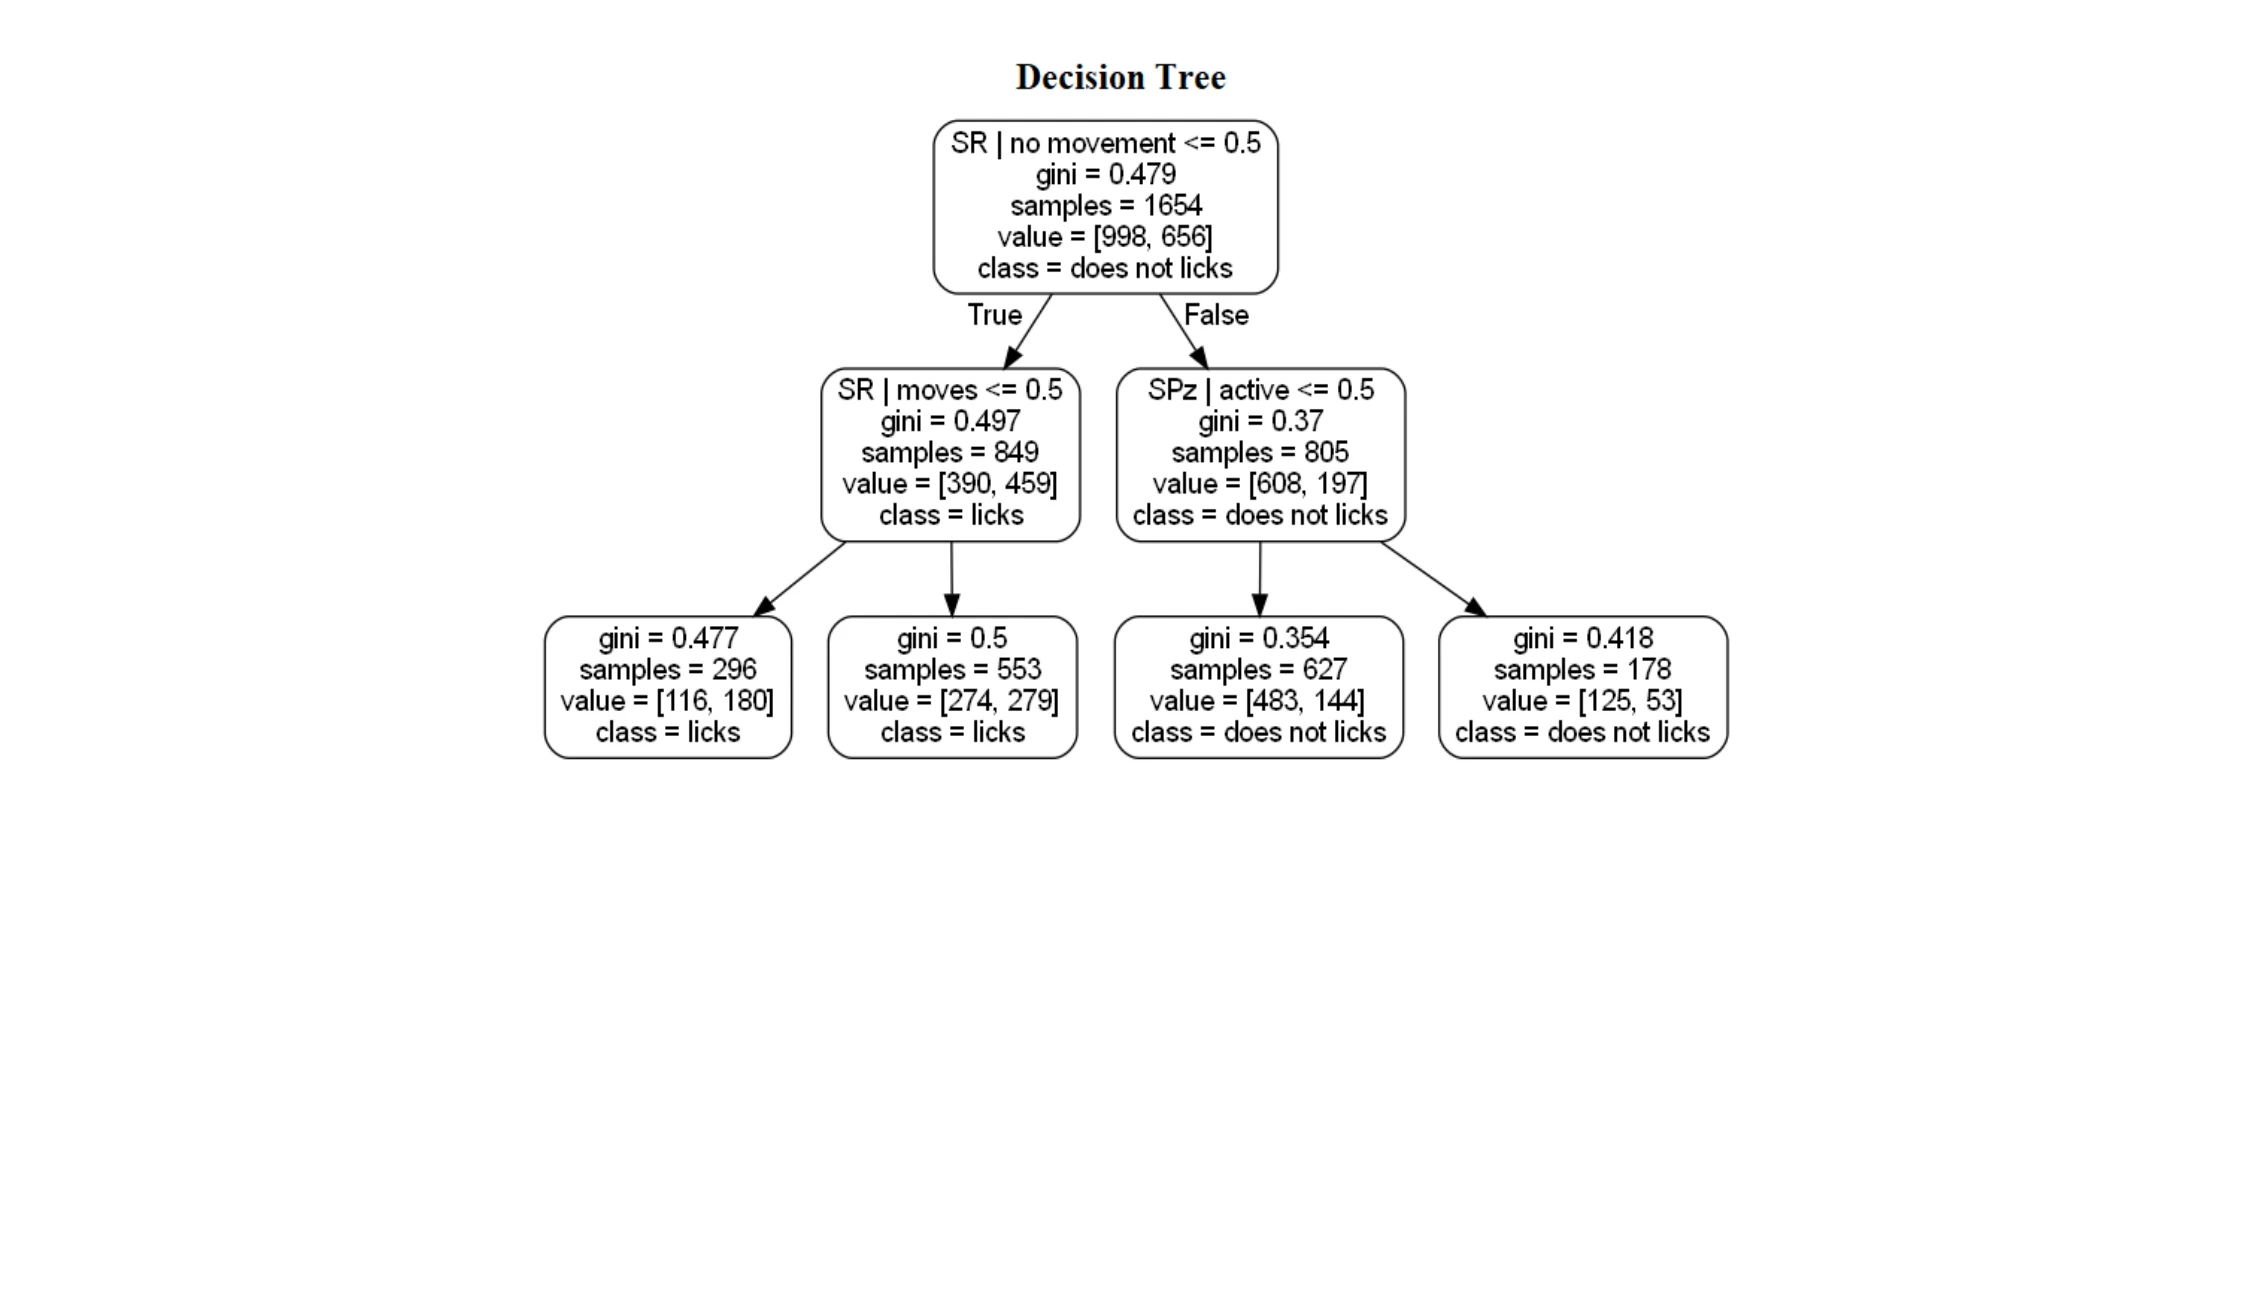
실제로 이 모델이 어떻게 판단했는지 나무 구조로 보면 이렇게 생겼어요. 맨 위에서 “스프레이했을 때 안 움직였는가”로 먼저 나누고, 그 다음 가지에서 각각 “스프레이했을 때 움직였는가”·”잠잘 때 활동적인 자세였는가”로 한 번씩 더 나눠서 최종 답(“핥는다”/”핥지 않는다”)에 도달해요. 딱 두 단계짜리 단순한 나무예요.
나무의 각 상자에 적힌 숫자를 보면 왜 스프레이 반응이 맨 위 질문으로 뽑혔는지 짐작할 수 있어요. 학습에 쓰인 1,654건 중 물을 뿌렸을 때 반응이 “무반응”이 아니었던 849건에서는 핥은 기록이 459건으로 안 핥은 390건보다 많았던 반면, “무반응”이었던 805건에서는 안 핥은 기록이 608건으로 핥은 197건을 크게 앞질렀어요. 여기서 세는 단위는 마리가 아니라 관찰 건수예요. 스프레이에 어떤 식으로든 반응을 보인 경우가 그 물을 핥아 먹은 기록과 함께 나타나는 경향이 있었던 거죠. 다만 이건 같은 스프레이 사건에서 함께 기록된 두 항목의 연관일 뿐이고, 이 연구로 “움직임이 핥기를 유발한다”는 인과를 말할 수는 없어요.
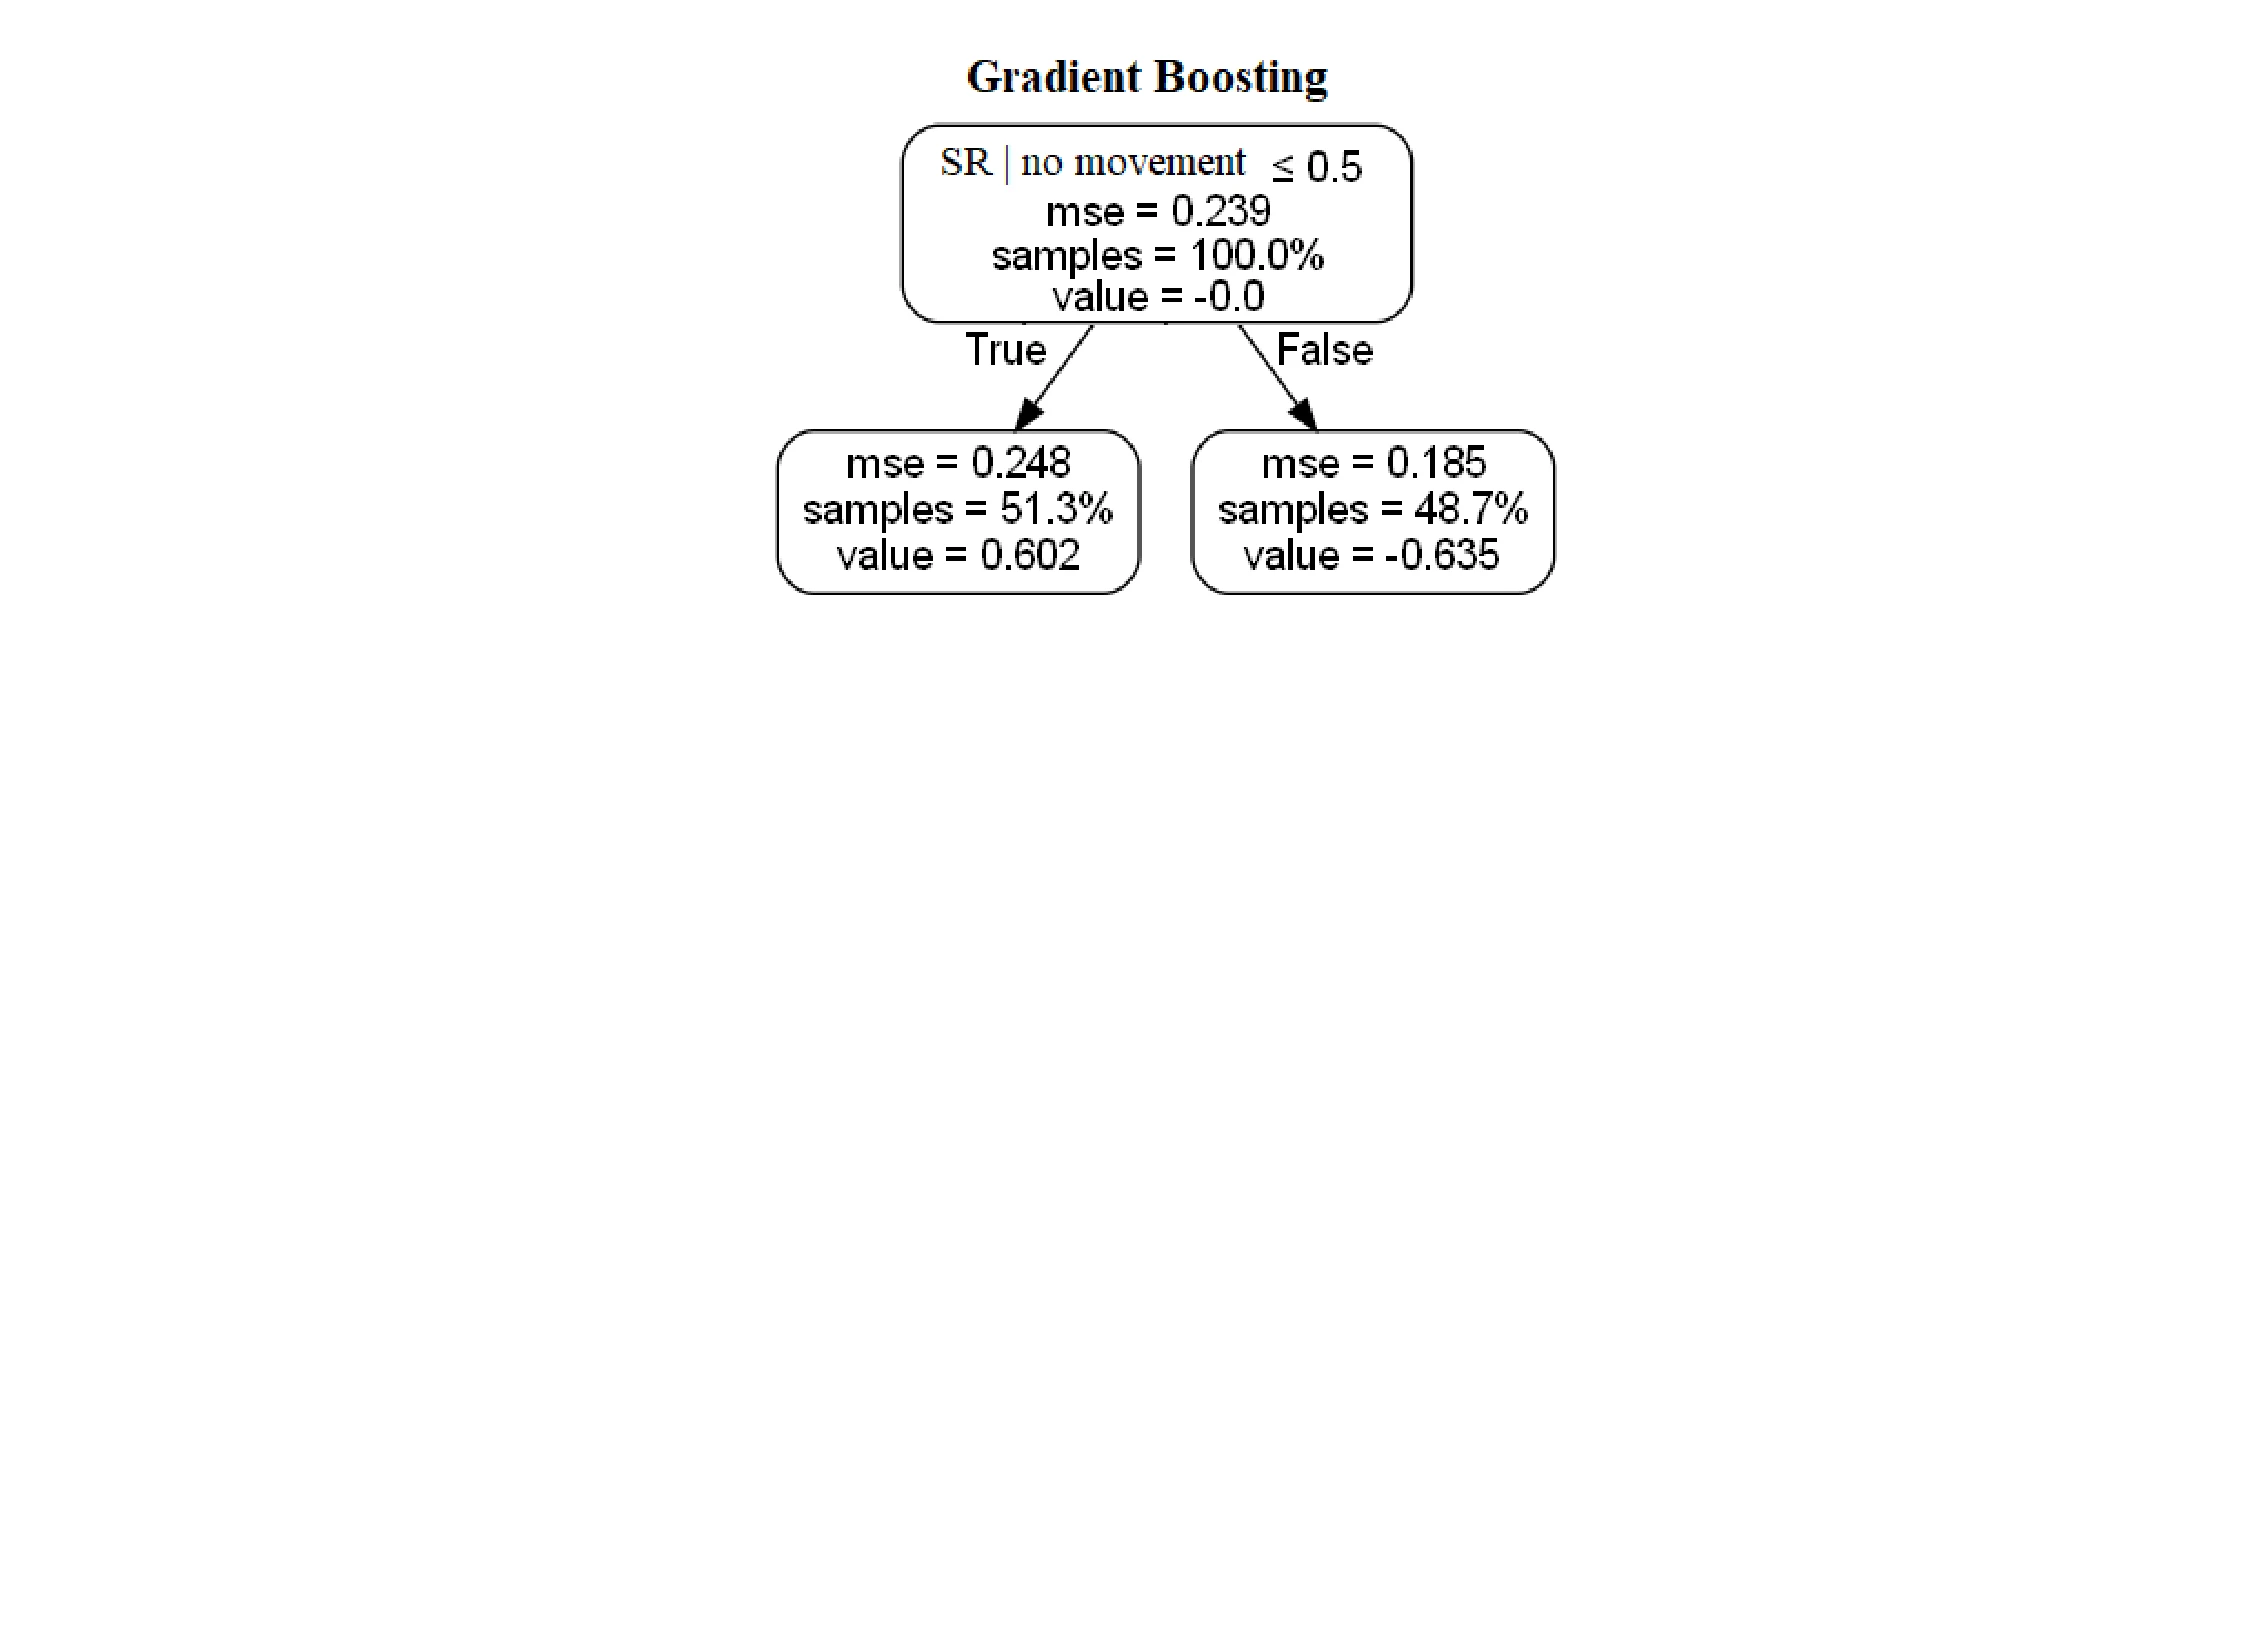
같은 항목을 그레이디언트 부스팅으로 만든 모델은 나무 100개로 이뤄져 있는데, 논문이 그림으로 실은 건 그중 첫 번째 나무 한 개예요. 그 한 개는 “스프레이했을 때 안 움직였는가” 질문 하나로 끝날 만큼 단순해요. 가지 끝에 적힌 값이 “핥는다”·”핥지 않는다” 같은 분류명이 아니라 숫자(value)로 나오는 이유는, 그레이디언트 부스팅이 예/아니오를 바로 답하는 대신 연속적인 점수를 계산하는 방식이기 때문이에요. 이 숫자는 그 자체로 확률이 아니라 최종 점수를 만드는 데 쓰이는 나무 하나의 출력값이에요. 초기 점수에 나무 100개의 출력을 학습률에 따라 차곡차곡 누적한 다음에야 확률로 변환돼요. 논문은 XGBoost 나무를 설명하면서 최종 합산값이 0이면 “핥는다”일 확률 50%에 해당하고 값이 커질수록 그쪽으로 기운다고 밝혔어요. 참고로 XGBoost 쪽은 같은 방식으로 실은 첫 나무가 가지 아홉 개짜리 훨씬 복잡한 형태였는데도, 이 항목의 성적은 나머지 둘보다 낫지 않았어요.
반대로 “손 위에서의 행동”이나 “사육장에 다시 넣은 후 행동”처럼 복잡하고 상황 의존적인 반응은 세 모델 다 F1-score가 0.2대에서 0.3대 사이에 머물렀어요. 이 정도면 실제로 쓸 만한 분류기로 보기는 어려운 수준이고, 논문도 “강한 분류 모델로 보기 어렵다”고 적었어요.
정리하면 세 모델 중 어느 하나가 일방적으로 우수하지는 않았어요. 의사결정나무는 스프레이 관련 두 항목에서, 그레이디언트 부스팅은 수면 관련 두 항목에서, XGBoost는 터치·핸들링 관련 세 항목에서 각각 가장 좋은 F1-score를 냈어요.
왜 정확도가 낮게 나왔을까
논문은 전반적인 정확도가 기대만큼(약 80% 이상) 높지 않았다고 스스로 인정했어요. 연구팀이 가장 유력하게 추정한 원인은 표본 크기예요. 20마리에서 나온 데이터로는 AI가 패턴을 배우기에 충분하지 않았을 거라는 거죠. 논문은 다른 동물·사람 대상 머신러닝 연구를 몇 편 들었는데, 영상에서 돼지의 승가(마운팅) 행동을 인식한 연구는 정확도 97%를 기록했고, XGBoost로 노인의 생체리듬 특성을 분석해 경도인지장애를 분류한 연구는 78%를 기록했어요. 두 연구 모두 이 연구보다 데이터가 훨씬 컸다는 게 연구팀이 강조한 대목이에요.
다만 이건 어디까지나 저자들의 추정이고, 논문이 데이터 양만 따로 떼어 검증한 건 아니에요. 비교 대상으로 든 연구들은 맞히려는 대상도, 답의 가짓수도, 데이터가 얼마나 치우쳐 있는지도, 자료를 나눈 방식도 전부 다르기 때문에 정확도 숫자만 나란히 놓고 우열을 가릴 수는 없어요. 데이터가 적었다는 사실 자체는 분명하지만, 그게 유일한 원인인지는 이 연구만으로 알 수 없다고 보는 편이 정확해요. 연구팀은 관찰값이 전부 범주형이었다는 점도 결과에 영향을 줬을 요인으로 함께 언급했어요.
이 연구가 왜 의미 있을까
연구팀이 서론에서 밝힌 동기는 “살아있는 동물을 대상으로 매번 실험하지 않고도 사육 관련 의사결정을 내릴 수 있는 모델”이었어요. 다만 이번 연구가 실제로 그 일을 해낼 수 있는지까지 검증한 건 아니에요. 제한된 환경에서 키운 20마리의 관찰 기록으로 행동 항목들 사이의 분류가 가능한지 가능성을 타진해본 단계에 가까워요.
그 범위 안에서 얻은 결론은 이래요. 답이 예/아니오에 가까운 단순한 항목(물을 뿌렸을 때 핥는지 여부)은 지금 수준의 데이터로도 정확도 60%를 넘겼지만, 맥락에 따라 달라지는 복잡한 행동은 그러지 못했다는 것. 그리고 크레의 행동을 머신러닝으로 모델링하는 것 자체는 가능하다는 것이에요.
논문은 마지막으로 앞으로의 방향도 언급했는데, 여기서 딥러닝 같은 신경망 모델을 함께 거론해요. 다만 이건 “정확도가 낮으니 딥러닝을 쓰면 해결된다”는 뜻이 아니에요. 언젠가 동물 행동 모델링이 고전적인 통계 대신 머신러닝 계열 방법으로 넘어갈 수 있고 그중에는 신경망도 있을 것이라는, 분야 전체에 대한 전망에 가까워요. 20마리·2,067건 규모에서 딥러닝이 더 나을 것이라는 근거는 이 논문에 없어요.
크레의 행동을 다룬 다른 연구가 궁금하다면, 새로운 물건 앞에서 크레와 레오파드게코가 어떻게 다르게 반응하는지 비교한 논문이나 크레가 색을 어떻게 보는지 실험한 논문도 정리해 뒀어요.
이 글은 아래 원 논문을 직접 읽고 참고문헌까지 확인해서 정리했어요.
출처: Pacoń J, Kosińska-Selbi B, Wełeszczuk J, Kochan J, Kruszyński W. “Modelling behavior of Crested gecko (Correlophus ciliatus) using classification algorithms.” Applied Animal Behaviour Science, 2024;281:106436. https://doi.org/10.1016/j.applanim.2024.106436
본문의 혼동 행렬·의사결정나무 그림은 위 논문에서 그대로 가져왔어요. 첫 사진은 Baby crested gecko by DigitalLem0n, CC BY-SA 4.0을 사용했어요.