모프 브리딩 확률표는 어떻게 읽을까
Punnett square(퍼넷 사각형)는 전제가 맞을 때 확률을 계산할 뿐, 그 유전 모델을 증명하지는 않아요. 부모의 유전형, 한 유전자좌의 대립유전자 관계, 생존과 표현형 판정 조건이 먼저 맞아야 표의 25%나 50%가 뜻을 가져요.
분양글에서 100% het, 50% possible het, 66% possible het를 보면 숫자가 아주 확실한 검사 결과처럼 느껴질 수 있어요. 하지만 이 숫자는 대부분 DNA 검사값이 아니라 부모의 유전형과 가정한 유전 모델에서 계산한 조건부 확률이에요. 표를 읽을 때는 먼저 “무슨 모델을 넣었는가”를 확인하고, 그다음 “유전형 확률을 표현형 확률로 바꿔도 되는가”를 따져야 해요.
나뭇가지에 함께 있는 야생 크레 두 마리예요. 사진에 보이는 모습만으로 각 개체의 유전형을 확정할 수는 없어요. 사진: Lennart Hudel, Correlophus ciliatus 33600735, CC BY 4.0, WebP 형식 변환.
이 글은 실제 페어를 추천하는 브리딩 매뉴얼이 아니에요. 기초 유전학에서 다룬 개념을 확률표에 적용하고, 크레의 모프와 형질 개론에서 정리한 근거의 차이가 계산에 어떤 한계를 만드는지 읽어 보는 글이에요.
먼저 여덟 단어만 복습해요
전문적으로는 한 개체가 한 유전자좌(locus)에 가진 대립유전자 조합을 유전형(genotype)이라고 하고, 그 결과 관찰되는 범주나 특징을 표현형(phenotype)이라고 해요. 쉽게 말하면 유전형은 가지고 있는 조합이고, 표현형은 밖에서 판정한 모습이에요.
| 용어 | 뜻 | 가상 기호로 쓴 예 |
|---|---|---|
| 대립유전자(allele) | 같은 유전자좌에 올 수 있는 서로 다른 형태 | A, a |
| 동형접합(homozygous) | 같은 대립유전자 두 개를 가짐 | AA, aa |
| 이형접합(heterozygous) | 서로 다른 대립유전자 하나씩을 가짐 | Aa |
| 우성(dominant) | 이형접합에서 표현형으로 드러나는 쪽 | 완전우성 모델의 A |
| 열성(recessive) | 이형접합에서는 가려지고 보통 동형접합에서 판정되는 쪽 | 완전우성 모델의 a |
| 불완전우성(incomplete dominance) | 이형접합이 두 동형접합과 구별되는 표현형을 보이는 관계 | AA, Aa, aa를 세 표현형으로 판정 |
| 헷(het) | heterozygous를 줄인 브리더 용어 | 열성 모프 대립유전자를 하나 가진 Aa |
| possible het | 헷일 가능성이 있지만 개체의 유전형은 아직 모르는 상태 | 50% possible het, 66% possible het |
우성과 열성은 개체의 우열, 건강, 가치, 희귀성 또는 형질의 좋고 나쁨을 뜻하지 않아요. 같은 유전자좌의 두 대립유전자가 이형접합에서 어떻게 표현되는지를 나타내는 관계예요. 또한 어떤 특징이 유전된다는 사실만으로 단일 유전자좌의 우성이나 열성이라고 정할 수도 없어요.
50% possible het인 개체가 대립유전자를 절반만 가졌다는 뜻도 아니에요. 실제 개체의 유전형은 AA 또는 Aa 가운데 하나예요. 다만 혈통과 모델만 알고 그 개체의 실제 유전형을 모를 때, Aa일 사전 확률을 50%로 적는 거예요.
표의 칸은 유전형이고, 겉모습은 한 번 더 번역해야 해요
Punnett square는 한쪽 부모가 만들 수 있는 생식세포를 위에, 다른 부모의 생식세포를 왼쪽에 놓고 조합해요. 예를 들어 부모가 모두 Aa라면 각각 A와 a를 절반씩 전달한다는 모델을 넣어요.
Aa × Aa |
A | a |
|---|---|---|
| A | AA | Aa |
| a | Aa | aa |
네 칸을 세면 유전형 기대확률은 다음과 같아요.
$$ P(AA)=\frac{1}{4},\qquad P(Aa)=\frac{1}{2},\qquad P(aa)=\frac{1}{4} $$
여기까지는 유전형 계산이에요. 표현형은 대립유전자 관계에 따라 달라져요. 완전우성 모델에서는 AA와 Aa가 같은 우성 표현형으로 묶여 75%, aa가 열성 표현형 25%가 돼요. 불완전우성 모델이라면 AA, Aa, aa 세 유전형을 각각 다른 표현형으로 판정할 수 있어서 25% : 50% : 25%가 그대로 표현형 비율이 될 수 있어요.
같은 표라도 모델이 달라지면 겉모습으로 번역한 답이 달라지는 셈이에요. 그래서 “표에서 네 칸 중 하나니까 비주얼 25%”라고 바로 말하면 중간 단계를 건너뛴 거예요.
완전우성: 같은 외형 안에 두 유전형이 숨어요
가상의 한 유전자좌에서 A가 a에 대해 완전우성이고, AA와 Aa의 외형이 같다고 가정해 볼게요. 부모가 Aa인 것을 이미 안다는 조건에서, 이 개체와 열성 표현형 aa의 교배를 표로 만들면 이래요.
Aa × aa |
a | a |
|---|---|---|
| A | Aa | Aa |
| a | aa | aa |
- 유전형 기대값:
Aa50%,aa50% - 표현형 기대값: 우성형 50%, 열성형 50%
이 교배는 교과서식 검정교배(test cross)의 형태이기도 해요. 우성 외형 때문에 AA인지 Aa인지 모르는 개체를 aa와 교배했을 때 열성형 자손이 나오면, 그 부모가 a를 전달했다는 강한 증거가 돼요. 반대로 열성형이 나오지 않았다고 곧바로 AA라고 확정할 수는 없어요. 자손 수가 적으면 Aa 부모에서도 우연히 우성형만 나올 수 있기 때문이에요.
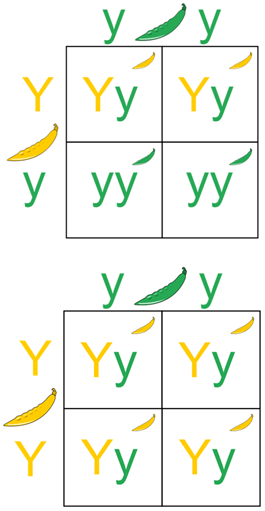
완두 종자색을 예로 든 검정교배예요. 미지의 우성 외형 개체가 Yy면 위처럼 두 유전형이 반씩 기대되고, YY면 아래처럼 모두 Yy가 돼요. 그림: KatieAnn127, Punnett Square Test Cross, CC BY-SA 4.0, WebP 형식 변환.
열성: 25%, 50%, 66%는 서로 다른 질문의 답이에요
열성형이 aa일 때 Aa × Aa를 다시 볼게요. 유전형은 AA 25%, Aa 50%, aa 25%예요.
| 자손 유전형 | 전체 수정란 기준 기대확률 | 완전우성일 때 겉모습 |
|---|---|---|
AA |
25% | 비발현형 |
Aa |
50% | 비발현형, 확정 het |
aa |
25% | 열성 발현형 |
여기서 25%는 열성 발현 유전형 aa가 될 모델상 확률이에요. 50%는 Aa가 될 확률이고요. 그런데 이미 부화해 열성 표현형이 아닌 것으로 판정된 자손만 골라 “이 개체가 헷일 확률은?”이라고 물으면 분모가 바뀌어요. aa 한 칸을 제외하고 남은 AA, Aa, Aa 세 칸 가운데 두 칸이 헷이므로 다음과 같아요.
$$ P(Aa\mid\text{비발현형}) =\frac{P(Aa)}{P(AA)+P(Aa)} =\frac{1/2}{1/4+1/2} =\frac{2}{3}\approx66.7\% $$
이게 흔히 말하는 66% possible het예요. 전체 수정란 중 헷이 66%라는 뜻이 아니라, Aa × Aa라는 부모 모델에서 열성 발현형이 아니라고 판정된 자손 가운데 헷일 조건부 확률이에요.
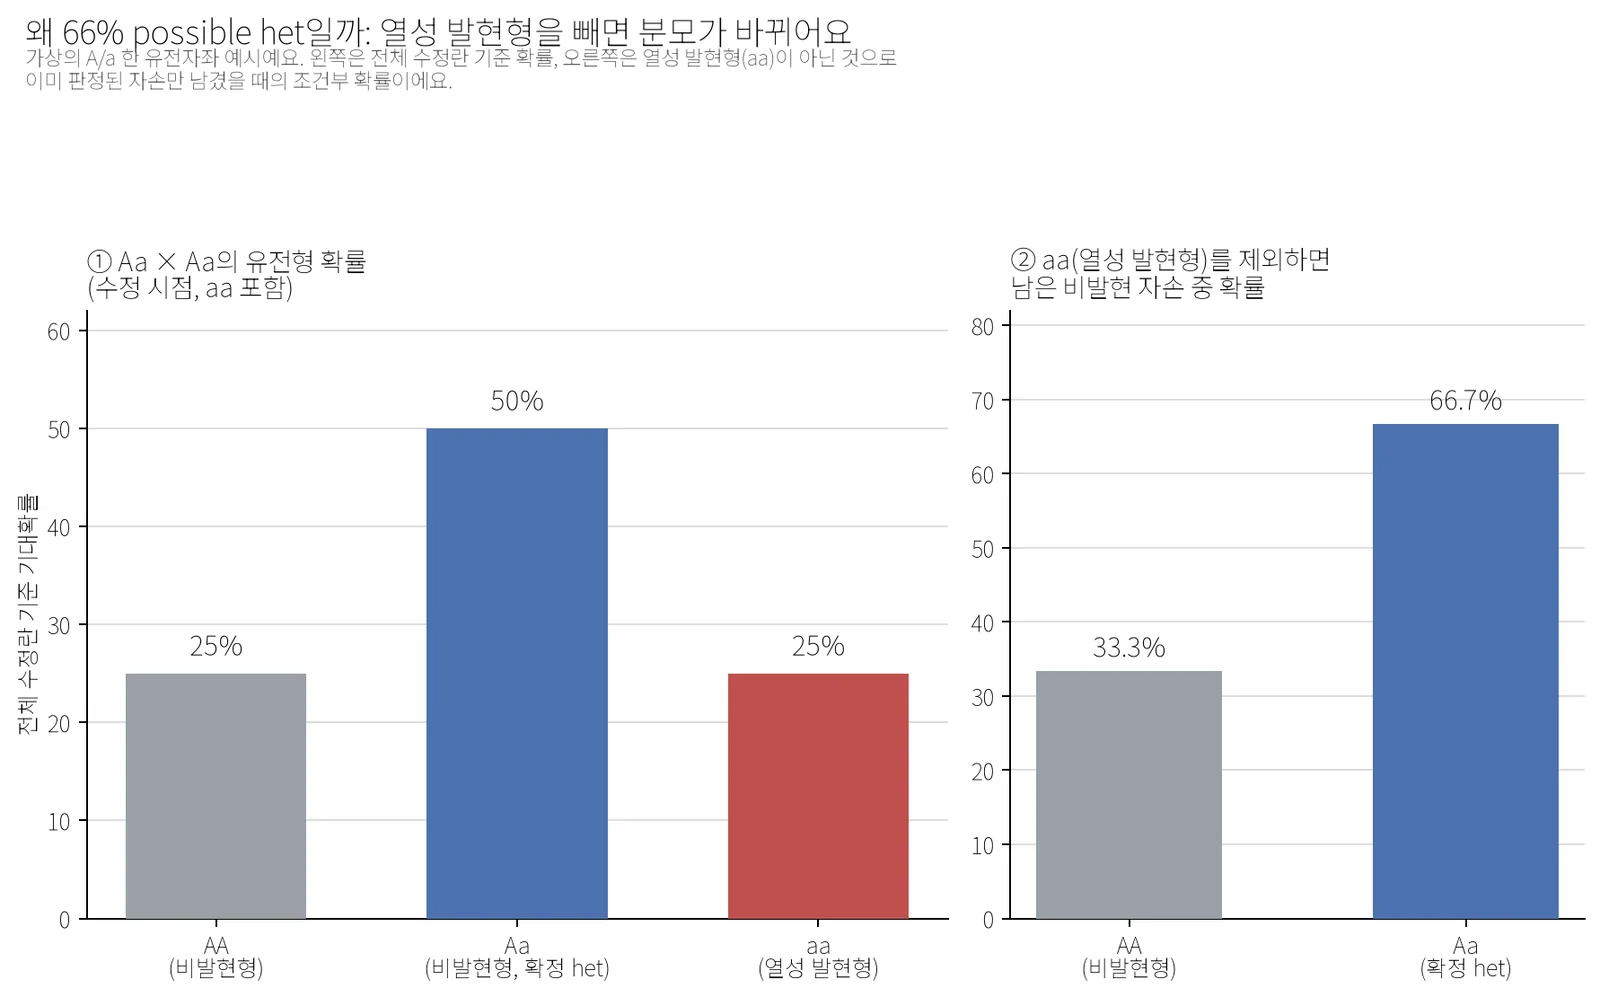
가상의 A/a 한 유전자좌 예시예요. 왼쪽 막대는 위 표의 수정 시점 유전형 확률(25%·50%·25%), 오른쪽 막대는 aa를 제외한 뒤의 조건부 확률(33.3%·66.7%)을 그대로 그래프로 옮겼어요.
50% possible het도 같은 방식으로 읽어요. 예를 들어 Aa × AA라면 자손은 AA 50%, Aa 50%이고 둘의 표현형이 같아요. 특정 비발현 자손은 실제로 둘 중 하나지만, 추가 정보가 없을 때 헷일 확률을 50%로 적어요.
| 표기 | 계산이 성립하는 대표 전제 | 정확한 뜻 |
|---|---|---|
| 100% het | aa × AA에서 나온 자손이라는 부모 유전형과 혈통이 맞음 |
모델상 모든 자손이 Aa |
| 50% possible het | Aa × AA에서 나온 비발현 자손이며 판정·혈통이 맞음 |
개체가 Aa일 사전 확률 1/2 |
| 66% possible het | Aa × Aa에서 나온 자손 중 aa 표현형을 제외했고 완전 침투한다고 가정 |
남은 개체가 Aa일 조건부 확률 2/3 |
possible het 확률은 새로운 정보가 생기면 바뀌어요. 검정교배에서 열성 자손이 확인되면 부모는 단순한 “66% 가능성”이 아니라 해당 대립유전자를 실제로 전달한 개체로 판정할 수 있어요. 반대로 자손이 몇 마리 모두 비발현형이라는 사실만으로 확률이 바로 0%가 되지는 않아요. 그 결과가 각 후보 유전형에서 얼마나 나올 법한지를 따져 갱신해야 해요.
25%는 알 네 개마다 한 마리라는 약속이 아니에요
확률표의 네 칸은 순서표가 아니에요. Aa × Aa에서 첫째가 AA, 둘째와 셋째가 Aa, 넷째가 aa로 정해지는 게 아니고, 수정이 일어날 때마다 같은 모델 아래에서 다시 추첨된다고 이해하면 쉬워요.
원하는 유전형의 확률이 각 수정란에서 \(p\)이고 각 결과를 독립 시행으로 근사한다면, 수정란 \(n\)개에서 그 유전형이 한 번 이상 나올 확률은 다음과 같아요.
$$ P(\text{한 번 이상})=1-(1-p)^n $$
예를 들어 \(p=0.25\), \(n=4\)를 넣으면 \(1-0.75^4\approx0.684\), 약 68.4%예요. 네 번이면 100%가 아니에요. 반대로 네 마리 중 두 마리가 해당 유전형이어도 모델이 바로 틀렸다는 뜻은 아니에요. 작은 표본은 기대비 주변에서 크게 흔들릴 수 있어요.
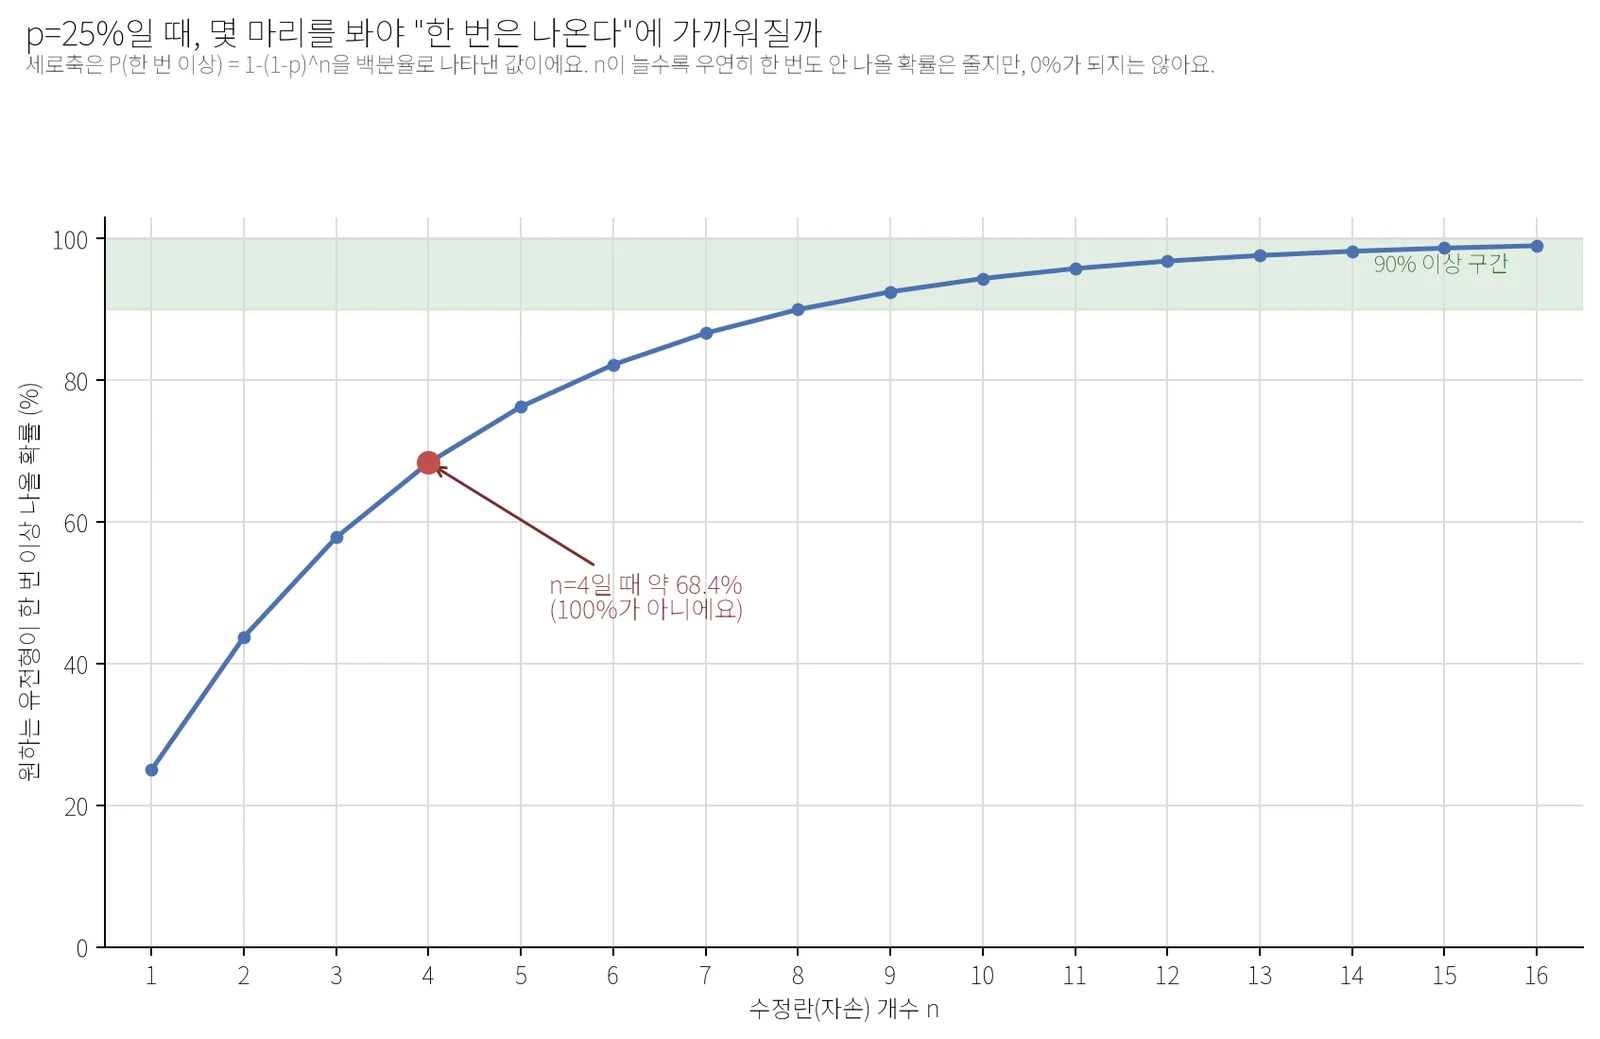
가상의 확률 \(p=0.25\) 예시예요. n=4에서 약 68.4%로, 100%까지는 아직 거리가 있다는 점과 표본이 늘수록 곡선이 완만하게 100%에 다가간다는 점을 함께 보여 줘요.
여기서 말하는 독립 시행은 계산을 위한 근사예요. 실제 브리딩 기록에서는 같은 부모, 같은 번식기, 같은 사육 환경을 공유하고 정자 저장이나 부계 오인도 생길 수 있으므로, 여러 알을 아무 조건 없이 완전히 독립된 증거 여러 건으로 세면 안 돼요.
불완전우성: 세 유전형을 세 표현형으로 나눌 수 있을 때
이번에는 가상의 A/a 한 유전자좌에서 AA, Aa, aa가 각각 강한형, 중간형, 기준형처럼 구별된다고 가정할게요. 기호의 대문자와 소문자는 여기서 개체의 우열을 뜻하지 않고, 두 대립유전자를 편하게 구분하기 위한 표시예요.
Aa × Aa의 표는 열성 예제와 똑같지만, 표현형으로 읽는 방식이 달라져요.
| 유전형 | 기대확률 | 가상 표현형 |
|---|---|---|
AA |
25% | 강한형 |
Aa |
50% | 중간형 |
aa |
25% | 기준형 |
전문적으로 불완전우성(incomplete dominance)은 이형접합체가 두 동형접합체와 구별되는 대립유전자 관계예요. 쉽게 말하면 Aa가 AA와도, aa와도 다른 모습으로 판정되어 유전형 세 종류가 겉모습 세 종류에 대응하는 모델이에요.
파충류 분양 정보에서 이런 관계를 co-dom이라고 부르는 일이 있지만, 학술적인 공우성(codominance)과는 달라요. 공우성은 이형접합체에서 두 대립유전자의 효과가 각각 식별되는 관계예요. 사람의 AB형 혈액형이 흔한 일반 유전학 예시예요. 현재 크레에서 공우성으로 확립됐다고 제시할 사례는 없어요. “슈퍼폼이 있다”거나 두 특징이 한 개체에서 함께 보인다는 이유만으로 공우성이라고 부를 수는 없어요.
크레 이름을 표에 넣기 전에 근거부터 확인해요
크레 모프는 아직 원인 유전자와 구체적 DNA 변이가 분자 수준에서 특정되지 않았어요. 현재 모델은 부모, 자손, 혈통, 여러 세대의 분리 양상을 읽는 전달유전학(transmission genetics), 곧 고전유전학·멘델 유전학에서 나왔어요. 멘델이 DNA를 직접 보지 않고 완두의 자손 비율로 유전 단위를 추론했듯이, 크레 브리더도 검정교배와 여러 세대의 기록으로 유전 가설을 시험해요. 다만 공개된 자손 수와 독립 재현의 두께는 모프마다 달라요.
- 아잔틱: 한 계통 안에서 열성 모델과 맞는 반복 관찰이 있어요. 하지만 여러 아잔틱 계통이 같은 유전자좌의 변이인지, 서로 교배했을 때 호환되는지는 별도의 질문이에요. 한 계통의
Aa × Aa표가 다른 모든 계통 조합에도 그대로 적용된다고 볼 수 없어요. - 릴리 화이트: 원 발견 브리더의 다년 기록은 비발현형과의 교배에서 약 절반 전달되는 불완전우성 모델을 강하게 지지해요. 릴리 화이트끼리의 교배에서는 균일한 백색 표현형의 부화 실패와 단기 폐사가 반복 보고됐고, 브리더들은 이를 동형접합 추정형으로 해석해요. 다만 전체 알과 발생 단계별 사망을 갖춘 유전형 검사는 공개되지 않아 “모든 동형접합체의 치사율 100%”라는 수치로 바꾸면 안 돼요. 정량적 치사율을 확정하지 못했다는 한계가 있지만, 반복된 부화 실패와 단기 폐사는 복지 판단에 충분히 중요한 경고예요. 따라서 릴리 화이트끼리의 교배는 피해야 해요.
- 카푸치노: 카푸치노끼리의 교배에서 슈퍼 카푸치노로 분류되는 표현형이 나온 기록은 브리더 동형접합 모델을 강하게 지지해요. 여러 나라의 후속 건강 조사는 그 표현형으로 분류된 개체의 건강 상태를 다룬 자료이지, 부모별 분리비나 유전형을 검정한 자료는 아니에요. 그래도 “슈퍼”라는 이름 자체가 동형접합을 증명하는 것은 아니며, 공개 자료에는 부모별 전체 자손 분리표와 분자 검사가 빠져 있어요.
- 세이블과 카푸치노: 세이블의 전달 관찰과 카푸치노의 기록은 각각 평가해야 해요. 두 모프가 같은 유전자좌의 서로 다른 대립유전자라는 설명은 Foundation Genetics가 판정 교배를 진행 중인 브리더 가설이에요. 2026년 8월 확인 기준 핵심 검증 단계가 남아 있으므로 같은 좌위로 확정해 확률표를 만들면 안 돼요.
이 차이는 크레의 모프와 형질 개론에서 각 이름별로 더 자세히 정리했어요. 모프 계산기도 확립·강한 근거·잠정·추정을 나눠 표시하지만, 숫자를 넣기 전에 각 모델의 출처와 한계를 먼저 확인해야 해요.
유전형 확률과 관찰 비율 사이에는 조건이 더 있어요
Punnett square의 유전형 확률을 실제로 센 자손의 표현형 비율과 비교하려면 몇 가지 조건이 추가돼요.
| 확인할 조건 | 어긋나면 생기는 일 |
|---|---|
| 부모 유전형과 부계가 맞는가 | 표에 넣은 생식세포 자체가 달라져요 |
| 한 유전자좌 모델이 맞는가 | 단순한 1:1, 3:1, 1:2:1로 설명되지 않을 수 있어요 |
| 표현형 판정 기준이 일관적인가 | 같은 유전형을 서로 다른 범주로 세거나 반대로 합칠 수 있어요 |
| 침투도가 충분한가 | 유전형을 가졌어도 표현형이 나타나지 않아 비발현형으로 잘못 세어요 |
| 표현도와 나이·파이어업·촬영 조건을 통제했는가 | 경계 개체의 판정이 시점과 관찰자에 따라 바뀔 수 있어요 |
| 유전형별 수정·발생·부화·생존률이 같은가 | 살아서 관찰된 자손 비율이 수정 시점의 유전형 확률과 달라져요 |
| 모든 알·사망·판정 불가 개체를 기록했는가 | 성공적으로 부화한 눈에 띄는 개체만 남아 비율이 왜곡돼요 |
침투도(penetrance)는 어떤 유전형을 가진 개체 가운데 해당 표현형이 실제로 나타나는 비율이고, 표현도(expressivity)는 나타난 특징의 정도가 개체마다 다른 현상이에요. 이 둘은 유전적 배경과 환경의 영향을 받을 수 있어요. 따라서 “겉으로 안 보인다”를 곧바로 “대립유전자가 없다”로 바꾸려면 완전 침투와 정확한 판정이라는 조건이 필요해요.
생존도 마찬가지예요. 수정 시점에 AA : Aa : aa = 1 : 2 : 1이더라도 한 유전형의 배아가 더 자주 죽는다면, 부화한 개체만 센 비율은 1:2:1이 아니게 돼요. 그래서 제대로 된 기록은 부모와 혈통뿐 아니라 전체 알, 미수정 추정, 배아 사망, 부화, 부화 후 사망, 판정 불가, 표현형별 생존 자손 수를 구분해야 해요. “슈퍼가 안 나왔다”는 한 문장만으로 동형접합 치사를 증명할 수 없는 이유예요.
여러 유전자좌의 확률은 아무 때나 곱하지 않아요
서로 다른 두 유전자좌를 가정해 볼게요. 첫 번째 좌위의 원하는 유전형 확률이 1/4이고, 두 번째 좌위도 1/4이라면 두 조건을 모두 만족할 확률을 흔히 이렇게 계산해요.
$$ P(aa\text{와 }bb)=P(aa)\times P(bb)=\frac{1}{4}\times\frac{1}{4}=\frac{1}{16} $$
하지만 이 곱셈에는 두 좌위가 독립적으로 분리되고 서로 연관되지 않았다는 전제가 필요해요. 두 유전자좌가 같은 염색체에서 가까이 있어 함께 전달되는 경향이 있거나, 한 유전자가 다른 유전자의 표현을 바꾸거나, 생존에 상호작용한다면 단순 곱셈이 맞지 않을 수 있어요.
특히 카푸치노와 세이블처럼 애초에 같은 좌위의 대립유전자인지, 서로 다른 독립 좌위인지가 검증 쟁점인 조합에는 먼저 1/4×1/4를 적용할 수 없어요. 독립 좌위라고 넣은 계산은 독립 좌위 가설의 예측일 뿐, 그 가설의 증명이 아니에요.
확률표를 볼 때 이 순서로 확인해요
- 무엇을 계산했는지 봐요. 수정 시점의 유전형인지, 부화한 자손의 표현형인지, 비발현 자손 가운데 헷일 조건부 확률인지 구분해요.
- 부모 유전형이 어떻게 확인됐는지 봐요. 외형, 혈통 추정, 검정교배, 여러 세대 기록은 확실성이 서로 달라요.
- 모델의 근거를 봐요. 단일 좌위와 우성·열성 관계가 반복 자료로 지지되는지, 아직 브리더 가설인지 확인해요.
- 분모를 봐요. 전체 알과 사망·판정 불가까지 셌는지, 살아서 판매된 자손만 셌는지 확인해요.
- 표본 수를 봐요. 작은 클러치가 기대비와 다르다고 즉시 반박도, 우연히 맞는다고 즉시 증명도 하지 않아요.
- 여러 좌위를 곱했다면 독립분리와 비연관 전제를 봐요. 좌위 관계가 검증 중이면 결과도 가설의 계산값으로만 읽어요.
결국 25%, 50%, 66%는 틀린 숫자가 아니에요. 조건을 생략했을 때 오해하기 쉬운 숫자예요. Punnett square는 “이 모델이 맞다면 무엇을 기대해야 하는가”를 아주 선명하게 보여 줘요. 반면 “이 모델이 실제로 맞는가”는 전체 자손 기록, 구분 가능한 교배 설계, 반복과 독립 재현, 생존과 판정 자료가 답해야 해요.
참고한 자료
- OpenStax Biology 2e, Mendelian Genetics: 분리·독립의 법칙, 확률, 검정교배, 불완전우성과 공우성의 교과서적 기준이에요.
- Kingdom & Wright (2022), Incomplete Penetrance and Variable Expressivity: 침투도와 표현도, 유전적 배경과 환경의 영향을 정리한 리뷰예요.
- Lilly Exotics, The Story of the Lilly White Crested Gecko (보존본): 릴리 화이트의 기원과 다년 교배를 남긴 원 발견 브리더 기록이에요. 전체 알과 단계별 사망 분모가 공개되지 않았다는 한계가 있어요.
- Foundation Genetics, Super Cappuccino PSA: 슈퍼 카푸치노로 분류된 개체의 건강 자료를 모은 브리더 공동 문서예요. 건강 조사이지 부모별 분리비 검정은 아니에요.
- Foundation Genetics, Sable and Cappuccino Discussions: 세이블과 카푸치노의 같은 유전자좌 대립유전자 가설과, 남아 있는 판정 교배 단계를 밝힌 브리더 공동 문서예요.